
*Цей матеріал є перекладом статті Таріка Шіхіпара (Thariq Shihipar) «Lessons from Building Claude Code: How We Use Skills» Посилання на оригінальну статтю: https://claude.dev/blog/lessons-from-building-claude-code-how-we-use-skills/
Скіли стали одним із найпопулярніших способів розширення можливостей Claude Code. Вони гнучкі, їх легко створювати та поширювати.
Однак ця гнучкість ускладнює розуміння того, які рішення працюють найкраще. Які скіли варто створювати? Як правильно організувати структуру скілів? Коли варто ділитися ними з іншими?
В Anthropic ми активно використовуємо скіли в Claude Code — наразі в роботі перебувають сотні таких скілів. За цей час ми визначили кілька закономірностей і сформулювали рекомендації, які допомагають нам прискорювати розробку за допомогою скілів.
ЩО ТАКЕ СКІЛИ?
Скіли — це папки з інструкціями, скриптами та ресурсами, які агенти можуть знаходити й використовувати, щоб виконувати завдання точніше та ефективніше. У цій статті передбачається, що Ви вже знайомі з основами роботи скілів.
Поширена хибна думка, з якою ми стикаємося, полягає в тому, що скіли— це «просто файли Markdown». Насправді це повноцінні папки, які можуть містити скрипти, ресурси, дані та інші матеріали, доступні агенту для пошуку, дослідження й опрацювання.
У Claude Code скіли також мають широкий набір параметрів конфігурації, зокрема можливість реєструвати динамічні хуки.
Ми з’ясували, що одні з найефективніших скілів у Claude Code повною мірою використовують можливості цих параметрів конфігурації та структури папок.
ТИПИ СКІЛІВ
Проаналізувавши всі внутрішні скіли Anthropic, ми виявили, що їх можна розподілити на дев’ять категорій. Найкращі скіли чітко належать до однієї категорії, тоді як ті, що намагаються охопити надто багато завдань, поєднують ознаки кількох категорій і заплутують агента.
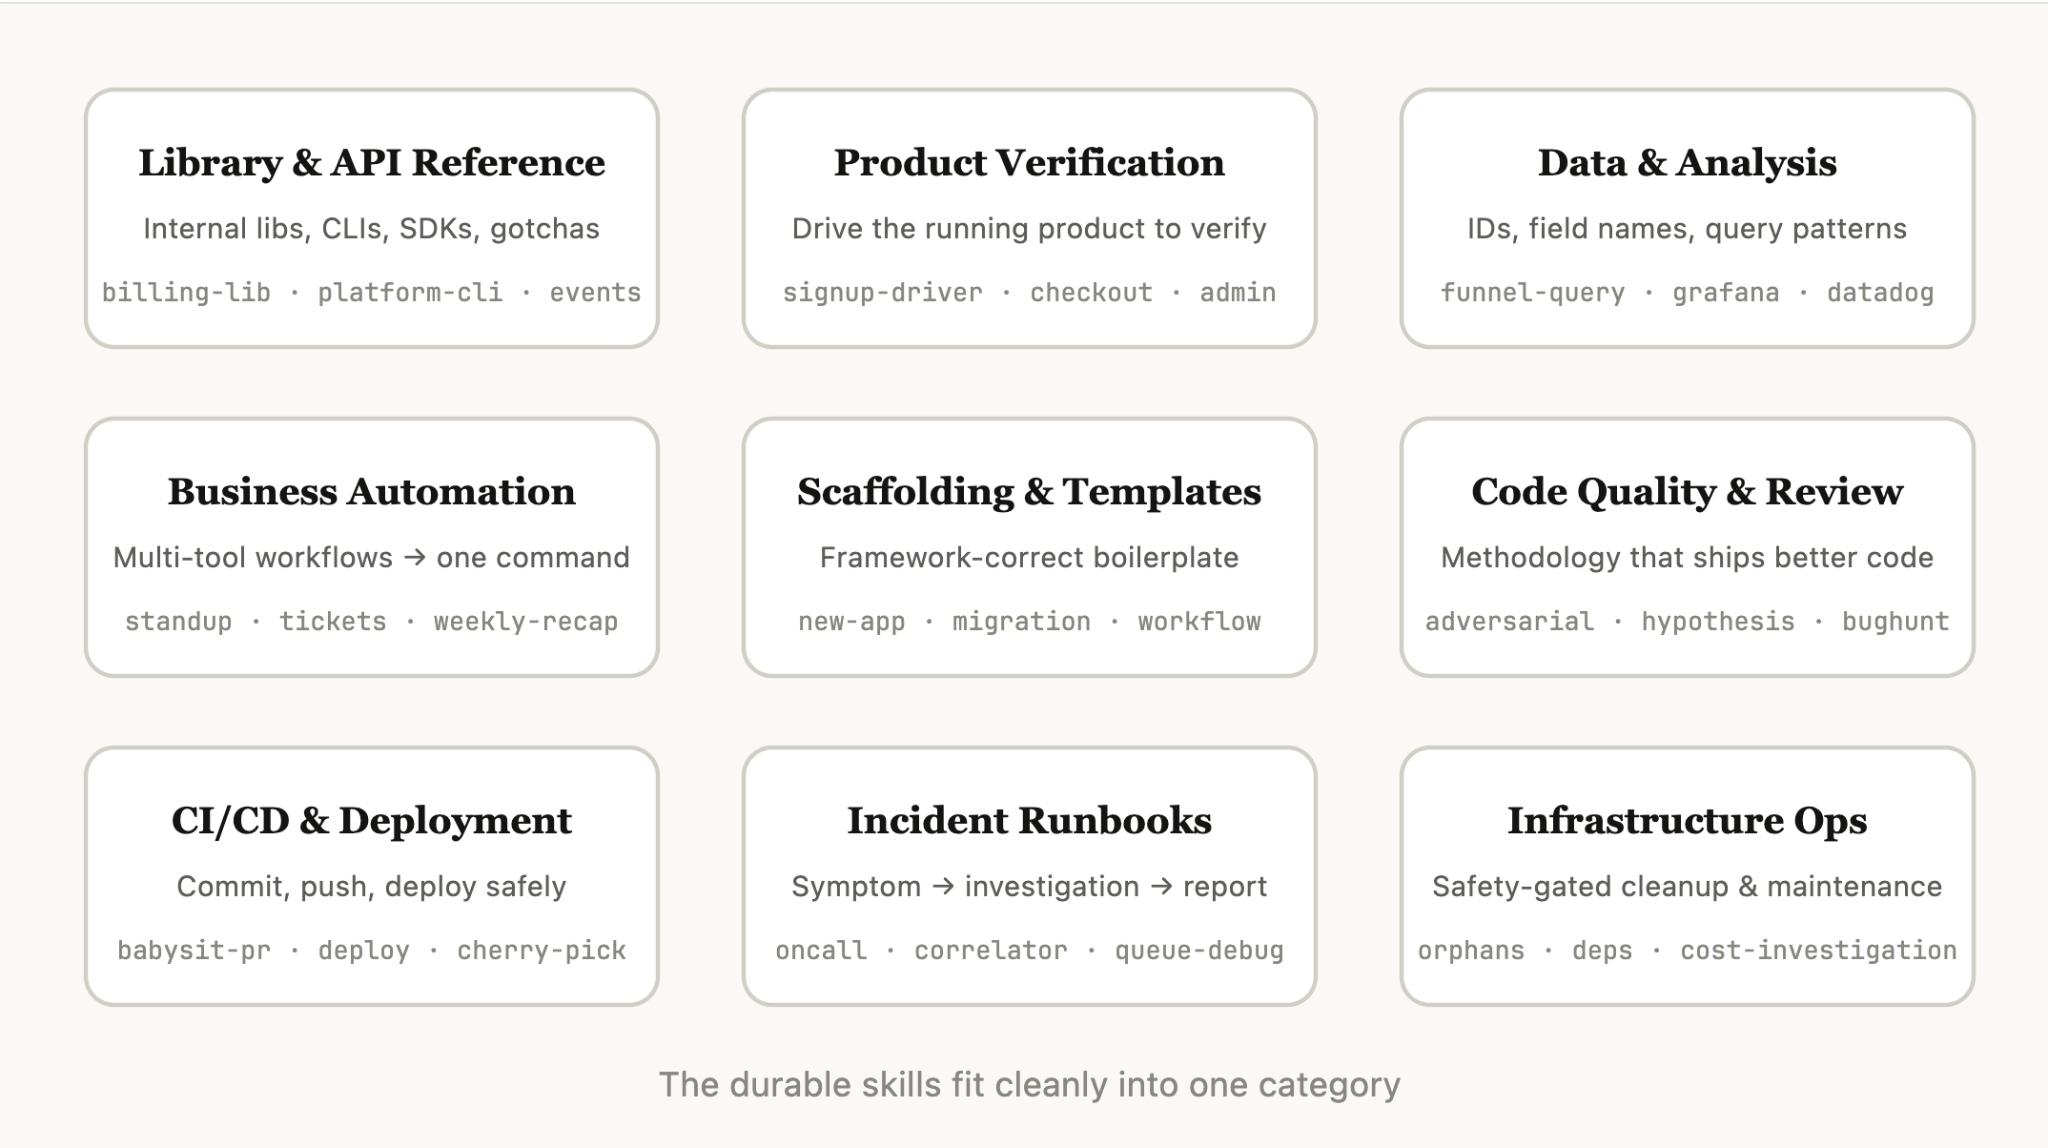 Цей перелік не є вичерпним, проте він становить корисну основу для виявлення прогалин у вашій власній бібліотеці скілів.
1. Довідкова інформація про бібліотеки та API (Library and API reference)
Це скіли, які пояснюють, як правильно використовувати бібліотеки, інтерфейси командного рядка (CLI) або комплекти засобів розробки (SDK). Вони можуть стосуватися як внутрішніх бібліотек компанії, так і загальнодоступних бібліотек, під час роботи з якими Claude Code іноді припускається помилок.
Такі скіли часто містять папку з прикладами коду та перелік типових помилок і підводних каменів, яких Claude має уникати під час написання скриптів.
Приклади:
- billing-lib — внутрішня бібліотека для роботи з платежами: граничні випадки, потенційно небезпечні особливості використання тощо.
- internal-platform-cli — усі підкоманди внутрішньої оболонки CLI з прикладами того, коли їх варто використовувати.
- sandbox-proxy — налаштування шлюзу вихідного трафіку організації для розробки: доступні хости, способи діагностики помилок «connection refused» (з’єднання відхилено), додавання записів до списку дозволених адрес.
2. Перевірка продукту (Product verification)
Це скіли, які описують, як тестувати код і перевіряти його працездатність. Часто вони використовують Playwright, tmux або інші зовнішні інструменти для перевірки.
Серед внутрішніх команд Anthropic саме скіли перевірки дали найбільш відчутний вимірюваний приріст якості результатів роботи Claude. Тому варто розглянути можливість залучити розробника, який протягом цілого тижня працюватиме над тим, щоб зробити ваші скіли перевірки максимально якісними.
Можна використовувати такі підходи, як запис відео результатів роботи Claude, щоб точно бачити, що саме він перевірив, або програмні твердження, які перевіряють стан системи на кожному етапі. Для цього до скіла часто додають різноманітні скрипти.
Приклади:
- signup-flow-driver — проходить увесь процес реєстрації: від створення облікового запису через підтвердження електронної пошти до початкового налаштування. Працює в безголовому браузері та має хуки для перевірки стану на кожному етапі.
- checkout-verifier — взаємодіє з інтерфейсом оформлення замовлення, використовуючи тестові картки Stripe, і перевіряє, чи рахунок-фактура справді перейшов у потрібний стан.
- tmux-cli-driver — використовується для інтерактивного тестування CLI, коли для перевірки потрібен термінал з підтримкою TTY.
3. Отримання й аналіз даних (Data fetching and analysis)
Це скіли, які забезпечують взаємодію з вашими системами даних і моніторингу. Вони можуть містити бібліотеки для отримання даних із використанням облікових даних, ідентифікатори конкретних інформаційних панелей, а також інструкції щодо типових робочих процесів і способів отримання даних.
Приклади:
- funnel-query — пояснює, які події потрібно об’єднати, щоб відстежити шлях користувача від реєстрації до активації та переходу на платний тариф. Також указує таблицю, яка містить канонічний ідентифікатор користувача (user_id).
- cohort-compare — порівнює утримання користувачів або конверсію в двох когортах, позначає статистично значущі відмінності та надає посилання на визначення сегментів.
- grafana — містить UID джерел даних, назви кластерів і таблицю відповідності між проблемами та інформаційними панелями.
- datadog — містить довідник полів (наприклад, @request_id і trace_id), перелік сервісів і правила найменування префіксів метрик.
4. Автоматизація бізнес-процесів і командної роботи (Business process and team automation)
Це скіли, які перетворюють повторювані робочі процеси на одну команду. Зазвичай вони складаються з відносно простих інструкцій, але можуть залежати від складніших механізмів, інших скілів або MCP.
Для таких скілів збереження попередніх результатів у файлах журналів може допомогти моделі підтримувати послідовність дій і враховувати результати попередніх запусків процесу.
Приклади:
- standup-post — збирає дані із системи відстеження завдань, активності на GitHub і попередніх повідомлень у Slack, а потім формує структурований звіт про виконану роботу, включаючи лише зміни порівняно з попереднім звітом.
- create-<ticket-system>-ticket — забезпечує дотримання схеми даних, зокрема допустимих значень перелічуваних полів і обов’язкових полів, а також виконує дії після створення завдання: повідомляє рецензента, додає посилання в Slack.
- weekly-recap — об’єднує інформацію про об’єднані PR, закриті завдання та розгортання, після чого формує структурований щотижневий звіт.
5. Каркаси коду та шаблони (Code scaffolding and templates)
Це скіли, які генерують базову структуру коду для конкретних завдань у певній кодовій базі та з використанням відповідного фреймворку. Їх можна поєднувати зі скриптами, які працюють разом як складові єдиного процесу.
Такі скіли особливо корисні, коли вимоги до створюваної структури сформульовані природною мовою і їх неможливо повністю реалізувати лише за допомогою коду.
Приклади:
- new-<framework>-workflow — створює базову структуру нового сервісу, робочого процесу або обробника з необхідними анотаціями.
- new-migration — містить шаблон файлу міграції та описує типові помилки й підводні камені.
- create-app — створює новий внутрішній застосунок із попередньо налаштованими механізмами автентифікації, логування та розгортання.
6. Якість коду та його перевірка (Code quality and review)
Це скіли, які забезпечують дотримання стандартів якості коду в організації та допомагають перевіряти його. Для підвищення надійності вони можуть використовувати детерміновані скрипти й інструменти.
Такі скіли можна автоматично запускати за допомогою хуків або в межах GitHub Actions.
Приклади:
- adversarial-review — запускає субагента, який незалежно аналізує код і критично оцінює його. Після цього система реалізує виправлення та повторює перевірку, доки серед виявлених проблем не залишаться лише незначні зауваження.
- code-style — забезпечує дотримання стилю написання коду, особливо тих вимог, яких Claude за замовчуванням дотримується недостатньо добре.
- testing-practices — містить інструкції щодо написання тестів і визначення того, що саме потрібно тестувати.
7. CI/CD і розгортання (CI/CD and deployment)
Це скіли, які допомагають отримувати, надсилати та розгортати код у межах вашої кодової бази. Для збору необхідних даних вони можуть звертатися до інших скілів.
Приклади:
- babysit-pr — відстежує стан PR, повторно запускає нестабільні перевірки CI, розв’язує конфлікти злиття та вмикає автоматичне злиття.
- deploy-<service> — виконує збірку, запускає базові перевірки працездатності (smoke-тести), поступово збільшує частку трафіку на новій версії, порівнює рівень помилок і автоматично відкочує зміни в разі погіршення показників.
- cherry-pick-prod — створює ізольоване робоче дерево Git, переносить вибрані коміти за допомогою cherry-pick, розв’язує конфлікти та створює PR за встановленим шаблоном.
8. Інструкції з діагностики та усунення проблем (Runbooks)
Це скіли, які беруть певний симптом — наприклад, обговорення в Slack, сповіщення або характерний код помилки, — проводять багатокрокове дослідження за допомогою кількох інструментів і формують структурований звіт.
Приклади:
- <service>-debugging — зіставляє симптоми, інструменти та шаблони запитів для сервісів із найбільшим обсягом трафіку.
- oncall-runner — отримує сповіщення, перевіряє найпоширеніші причини проблеми та формує звіт із результатами діагностики.
- log-correlator — отримує ідентифікатор запиту (request ID) і збирає відповідні журнали з усіх систем, які могли обробляти цей запит.
9. Експлуатація інфраструктури (Infrastructure operations)
Це скіли, які виконують регулярне технічне обслуговування та операційні процедури. Деякі з них передбачають потенційно руйнівні дії, тому потребують додаткових запобіжників. Такі скіли допомагають розробникам дотримуватися найкращих практик під час виконання критично важливих операцій.
Приклади:
- <resource>-orphans — знаходить ресурси Kubernetes, які залишилися без прив’язки до відповідних об’єктів, наприклад поди або томи, повідомляє про них у Slack, витримує період очікування та запитує підтвердження користувача перед каскадним очищенням.
- dependency-management — реалізує внутрішній процес погодження залежностей в організації.
- cost-investigation — допомагає з’ясувати причини різкого зростання витрат на зберігання даних або вихідний мережевий трафік, використовуючи конкретні сегменти даних і шаблони запитів.
ПОРАДИ ЩОДО СТВОРЕННЯ СКІЛІВ
Коли ви вже визначилися з скілом, який хочете створити, постає питання: як правильно його написати? Нижче наведено найкращі практики, поради та прийоми, якими користується команда Claude Code під час розроблення скіла.
Не описуйте очевидне
Claude вже вміє писати код і читати вашу кодову базу. Якщо скіл лише повторює те, що Claude і так зробив би за замовчуванням, він збільшує обсяг контексту, але не додає цінності.
Якщо ви публікуєте скіл, основна мета якого — передавання знань, зосередьтеся на інформації, яка допоможе Claude вийти за межі його звичних підходів до роботи.
Чудовим прикладом є скіл frontend-дизайну. Його створив інженер Anthropic, і він вдосконалювався в процесі спільної роботи з клієнтами над покращенням дизайнерського смаку Claude. Зокрема, він допомагає уникати шаблонних рішень, таких як шрифт Inter і фіолетові градієнти.
Створіть розділ із типовими помилками та підводними каменями
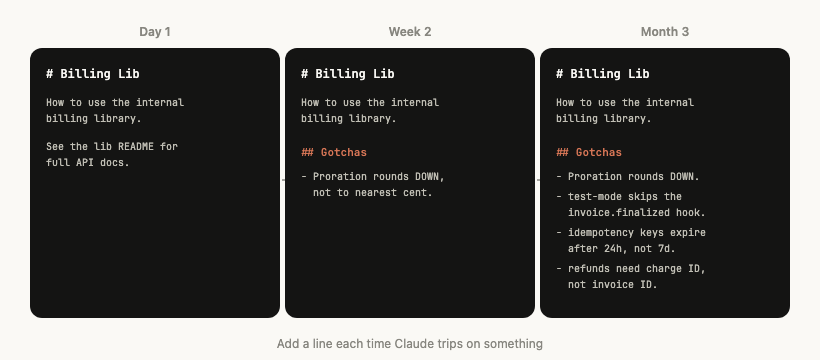
Найцінніша інформація в будь-якому скілі міститься в розділі Gotchas — типові помилки та підводні камені. Цей розділ має формуватися на основі поширених проблем, з якими Claude стикається під час використання скіла. В ідеалі ви маєте регулярно оновлювати скіл, доповнюючи цей розділ новими виявленими проблемами.
Наприклад:
- «Таблиця subscriptions працює в режимі додавання записів без їх зміни чи видалення (append-only). Потрібний запис — той, що має найбільшу версію, а не найновіше значення created_at.»
- «У шлюзі API це поле називається @request_id, а в платіжному сервісі — trace_id. В обох випадках йдеться про одне й те саме значення.»
- «У середовищі Staging повертається код 200, навіть якщо вебхук Stripe фактично не було оброблено. Щоб дізнатися реальний стан, перевірте таблицю payment_events.»
Використовуйте файлову систему та принцип поступового розкриття інформації
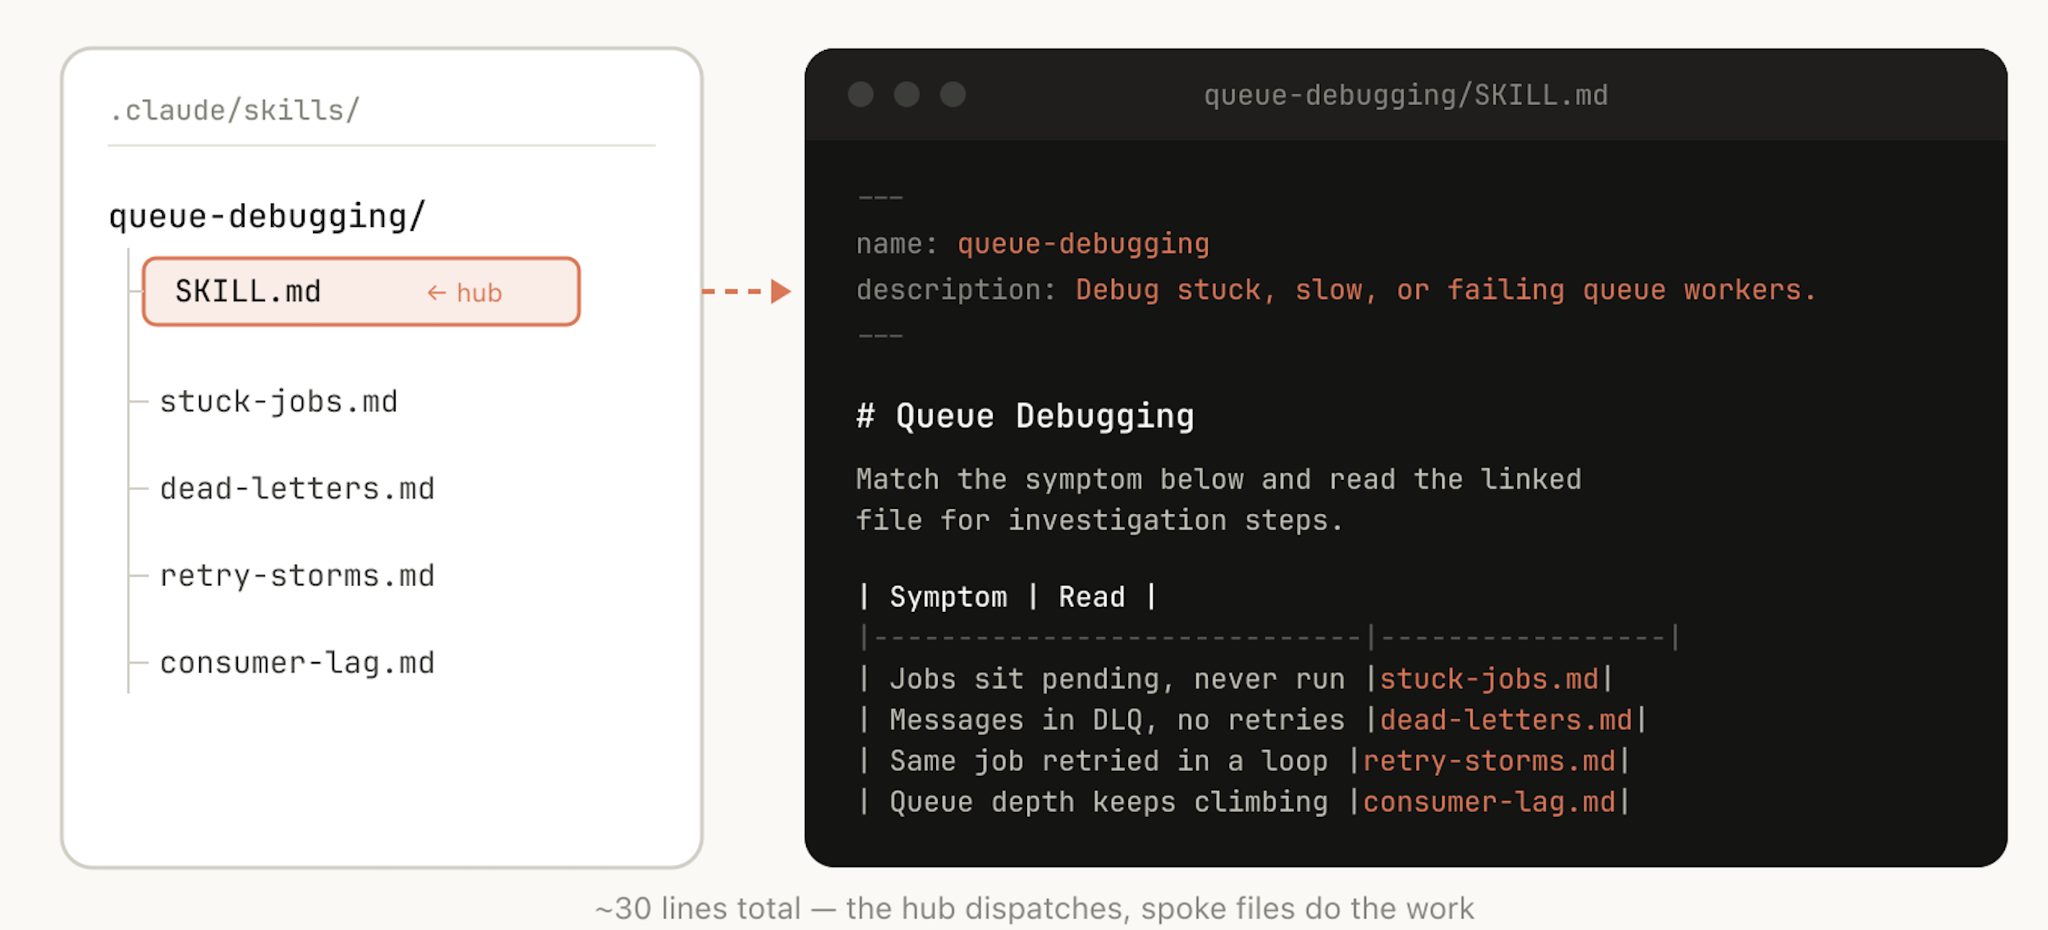
Файл SKILL.md містить посилання на кілька інших файлів, до яких Claude може звертатися в певних ситуаціях. Наприклад, якщо завдання перебуває в стані очікування, Claude має звернутися до файлу stuck-jobs.md, який описує, як діяти в такому випадку.
Як ми вже зазначали, скіл— це папка, а не просто файл Markdown. Варто розглядати всю файлову систему як інструмент контексту розробки та поступового розкриття інформації. Вкажіть Claude, які файли містить скіл, і він читатиме їх у відповідний момент.
Найпростіший спосіб реалізувати поступове розкриття інформації — посилатися на інші файли Markdown, які Claude може використовувати за потреби. Наприклад, докладні сигнатури функцій і приклади їх використання можна винести в окремий файл references/api.md.
Інший приклад: якщо кінцевим результатом роботи має бути файл Markdown, можна додати до папки assets/ файл із шаблоном, який Claude зможе скопіювати та використати.
Також можна створювати окремі папки з довідковими матеріалами, скриптами, прикладами тощо, які допоможуть Claude працювати ефективніше.
Не обмежуйте Claude надмірно жорсткими інструкціями
Зазвичай Claude намагається дотримуватися ваших інструкцій. Оскільки скіли можна повторно використовувати в різних ситуаціях, важливо не формулювати інструкції надто конкретно.
Надавайте Claude необхідну інформацію, але залишайте йому достатньо свободи, щоб адаптуватися до конкретної ситуації.
Наприклад:
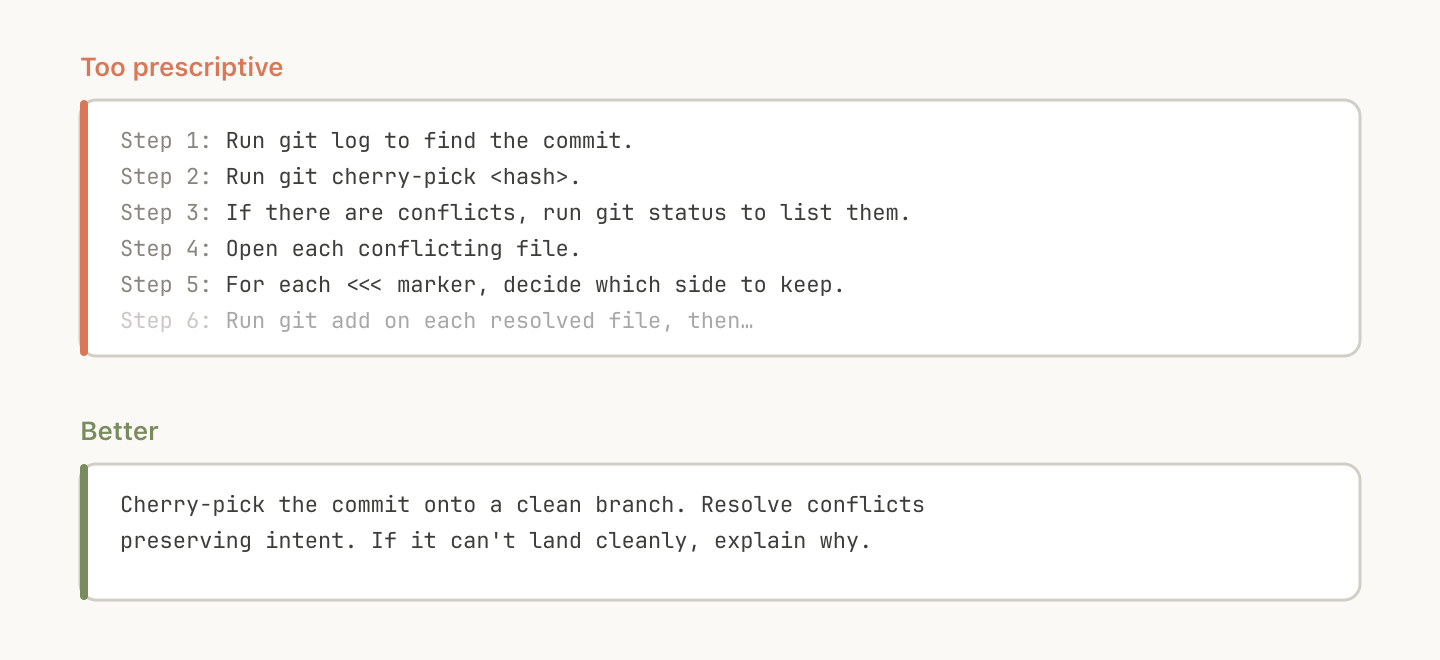
Сформулюйте мету й обмеження, а не розписуйте кожен крок.
Продумайте початкове налаштування
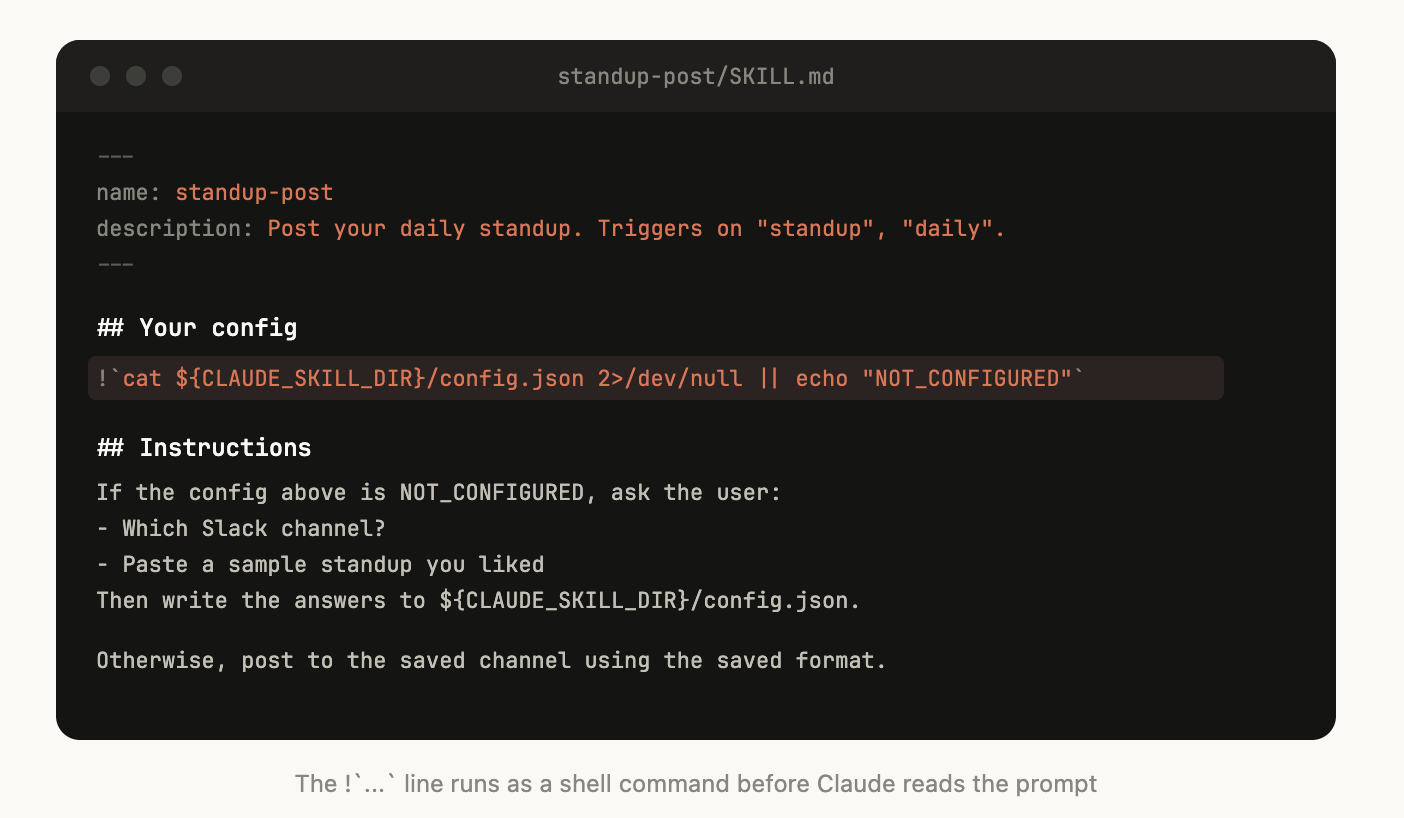
Описаний вище скіл налаштований так, щоб запитувати користувача, у якому каналі Slack потрібно опублікувати повідомлення, якщо цю інформацію не зазначено в конфігурації.
Для роботи з деякими скілами може знадобитися попередньо отримати від користувача додаткову інформацію. Наприклад, якщо ви створюєте скіл, який публікує щоденний звіт про виконану роботу в Slack, Claude може запитати, у якому каналі Slack потрібно опублікувати повідомлення.
Зручний підхід — зберігати ці налаштування у файлі config.json у папці скіла, як у наведеному вище прикладі. Якщо конфігурацію ще не налаштовано, агент може запитати в користувача необхідну інформацію.
Якщо потрібно, щоб агент ставив структуровані запитання з кількома варіантами відповідей, можна вказати Claude використовувати інструмент AskUserQuestion.
Пишіть описи для моделі, а не для людей
Коли Claude Code запускає сеанс, він формує перелік усіх доступних скілів разом із їхніми описами. Claude переглядає цей перелік, щоб визначити, чи є скіл, який підходить для поточного запиту.
Отже, поле description — це не короткий виклад призначення скіла, а опис умов, за яких його потрібно активувати.
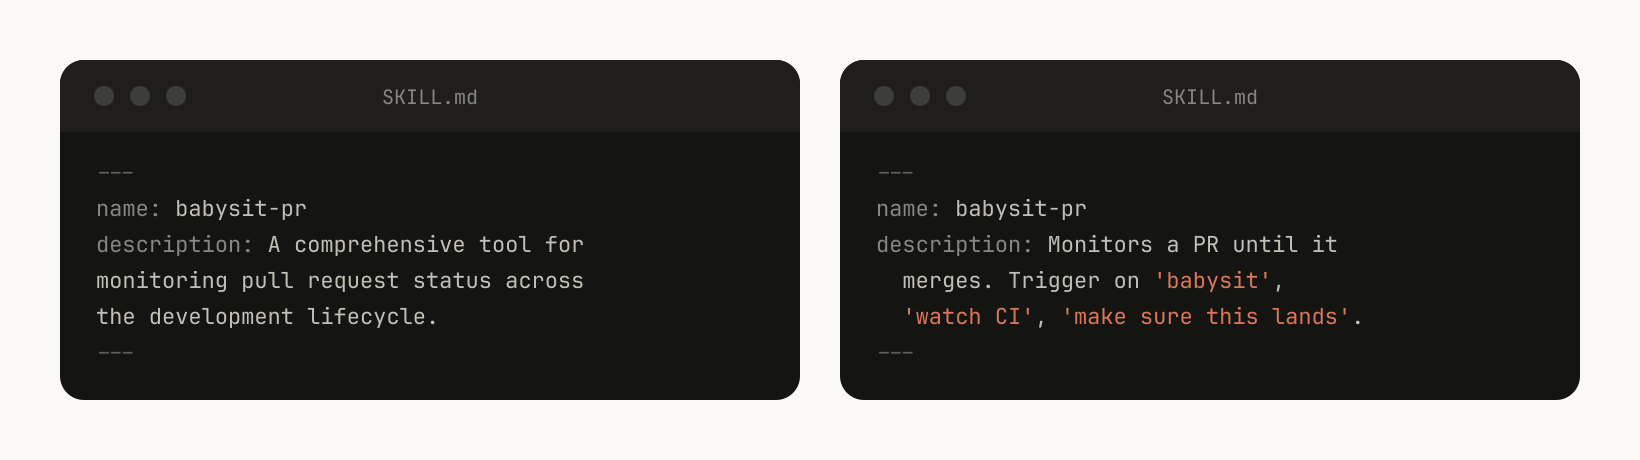
Корисно зазначати в описі скіла ключові слова-тригери, які вказують, коли його потрібно активувати, наприклад «babysit» («відстежувати й контролювати процес»).
Допоможіть Claude зберігати інформацію в пам’яті
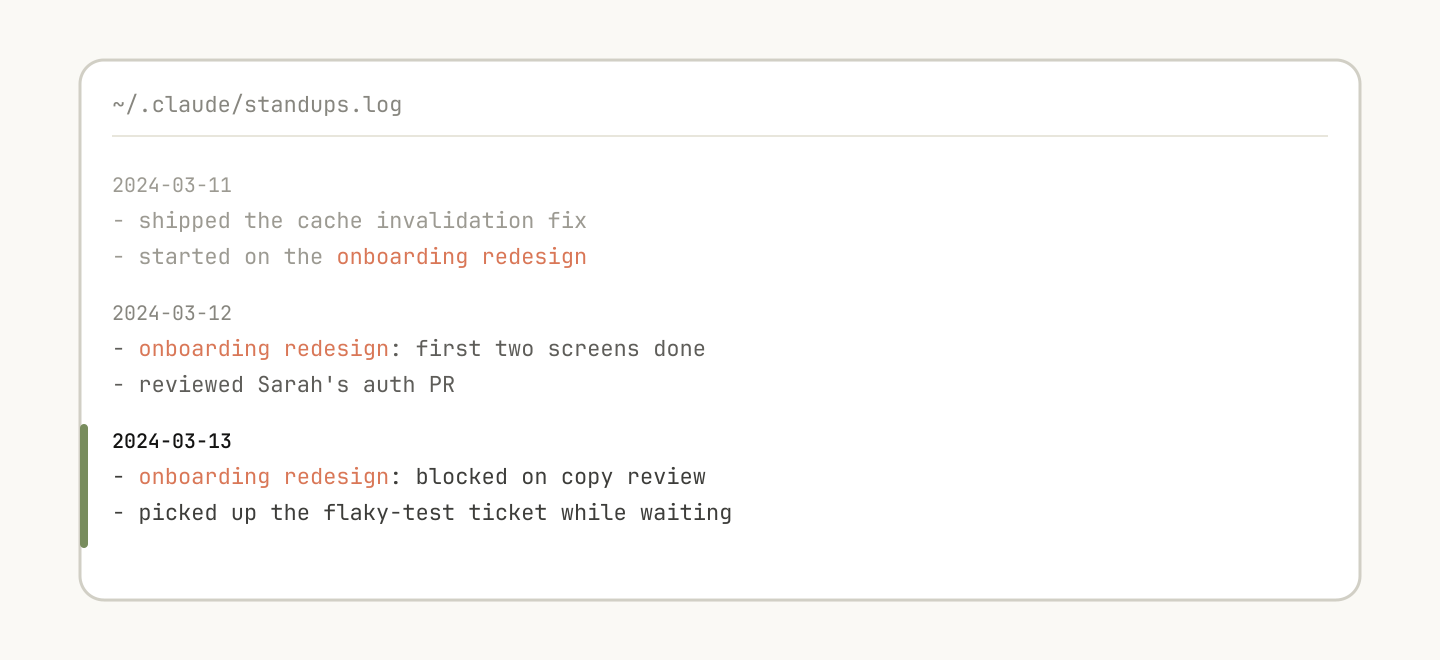
Цей текстовий лог-файл допомагає Claude зберігати в пам’яті події, що відбулися раніше, наприклад перевірку PR Сари, пов’язаного з автентифікацією.
Деякі скіли можуть мати власну систему пам’яті завдяки збереженню даних у своїй структурі. Для цього можна використовувати як простий текстовий файл журналу, у який лише додаються нові записи, або файли JSON, так і складніші рішення, наприклад базу даних SQLite.
Наприклад, скіл standup-post може зберігати всі створені звіти у файлі standups.log. Під час наступного запуску Claude зможе прочитати попередні записи та визначити, що змінилося від учорашнього дня.
Для зберігання даних можна використовувати змінну середовища ${CLAUDE_PLUGIN_DATA}, яка вказує на стабільний каталог для збереження інформації.
Докладніше про збереження даних у скілах: каталог постійного зберігання даних у документації Claude Code.
Зберігайте скрипти та генеруйте код
Один із найпотужніших інструментів, які можна надати Claude, — це код. Якщо забезпечити Claude доступ до готових скриптів і бібліотек, він зможе зосередитися на їх поєднанні та визначенні наступних кроків, замість того щоб щоразу відтворювати стандартний код із нуля.
Наприклад, у скілі data-science можна зберігати бібліотеку функцій для отримання даних із джерела подій. Щоб Claude міг виконувати складний аналіз, йому можна надати набір допоміжних функцій, як-от:
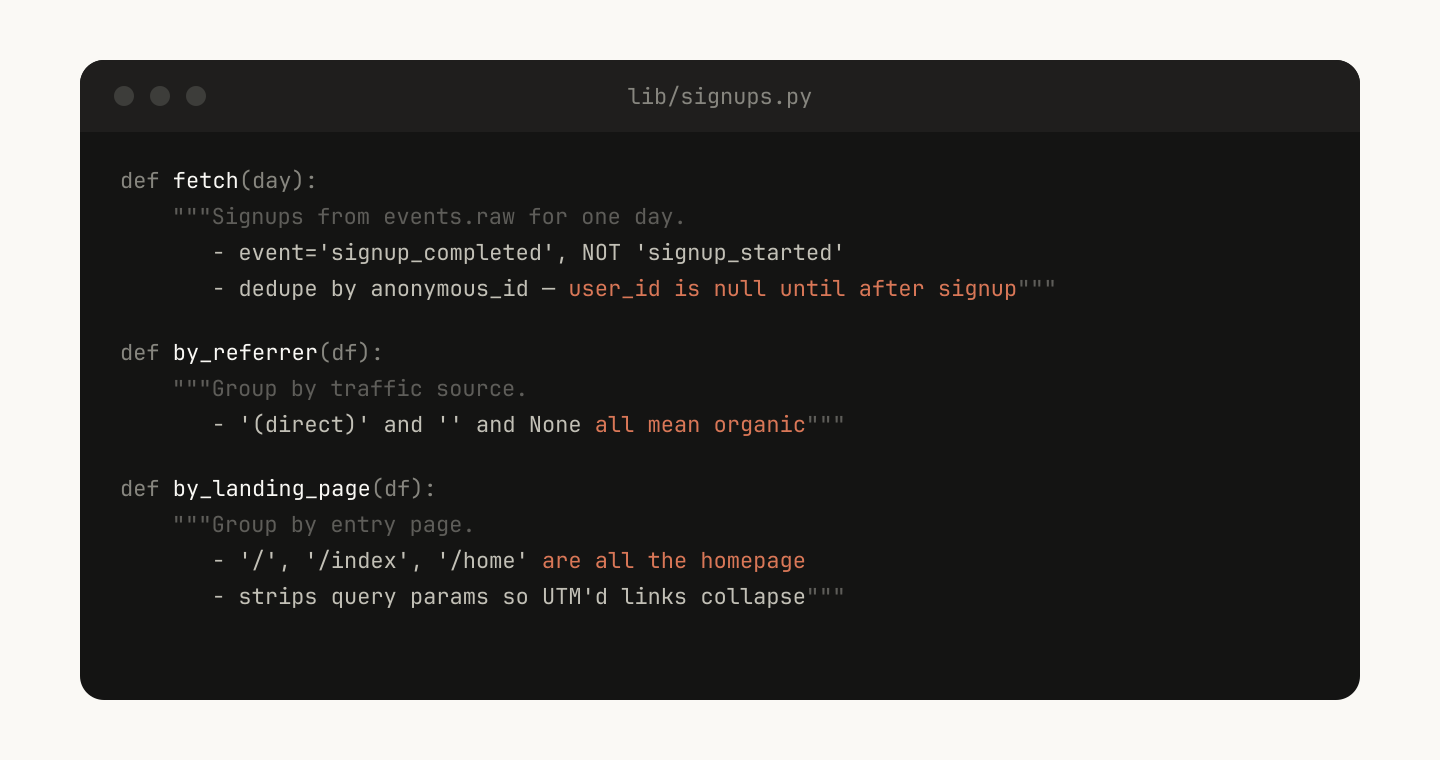
Надайте Claude невелику бібліотеку допоміжних функцій, додавши до їхніх docstring-описів інформацію про типові помилки та підводні камені.
Після цього Claude зможе на льоту генерувати скрипти, комбінуючи наявні функції для виконання складнішого аналізу у відповідь на запити на кшталт «Що сталося у вівторок?».
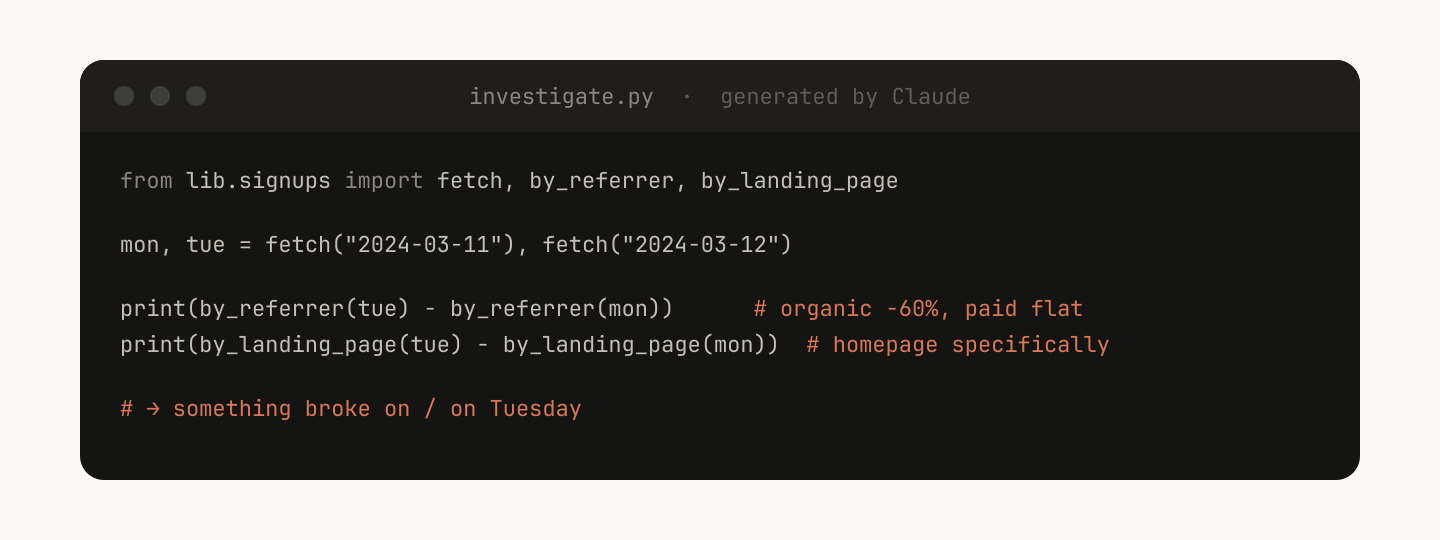
Claude комбінуватиме ці функції в одноразовий скрипт, адаптований до конкретного запитання.
Використовуйте хуки, які активуються за потреби
Скіли можуть містити хуки, які активуються лише під час виклику відповідного скіла та діють тільки протягом поточного сеансу. Це дає змогу використовувати суворіші правила, які не потрібно застосовувати постійно, але які можуть бути надзвичайно корисними в окремих ситуаціях.
Наприклад:
- /careful — блокує виконання команд rm -rf, DROP TABLE, примусового надсилання змін до віддаленого репозиторію (force-push) і видалення ресурсів через kubectl delete. Для цього використовується перехоплювач PreToolUse із фільтром Bash. Такий режим потрібен лише тоді, коли ви працюєте з промисловим середовищем (production). Якби він був увімкнений постійно, це неабияк ускладнювало б роботу.
- /freeze — блокує будь-які операції редагування або запису (Edit/Write) за межами визначеної директорії. Корисно під час налагодження, коли потрібно додати журнали подій, але є ризик випадково змінити сторонній код.
ПОШИРЕННЯ СКІЛІВ
Одна з головних переваг скілів — можливість ділитися ними з іншими членами команди.
Є два основні способи поширення скілів:
- Додати скіл до репозиторію вашого проекту в директорію ./.claude/skills.
- Створити плагін і використовувати маркетплейс плагінів Claude Code, де користувачі можуть завантажувати й встановлювати плагіни. Докладніше — у документації про маркетплейси плагінів Claude Code.
Для невеликих команд, які працюють із відносно невеликою кількістю репозиторіїв, зберігання скілів безпосередньо в репозиторіях працює добре. Однак кожний доданий скіл дещо збільшує обсяг контексту моделі.
Коли кількість скілів зростає, внутрішній маркетплейс плагінів дає змогу централізовано поширювати їх, залишаючи за командою право самостійно обирати, які саме скіли встановлювати. Крім того, він може містити процедуру початкового налаштування.
КЕРУВАННЯ МАРКЕТПЛЕЙСОМ СКІЛІВ
Як визначити, які скіли мають потрапити до маркетплейсу? Як організувати подання нових скілів?
В Anthropic немає централізованої команди, яка ухвалює такі рішення. Натомість ми намагаємося виявляти найкорисніші скіли природним шляхом.
Якщо хтось створив скіл, який хоче запропонувати іншим для тестування, він може завантажити його до спеціальної експериментальної папки в GitHub, а потім поділитися посиланням у Slack або на інших платформах для спілкування.
Коли скіл стає популярном, його автор сам вирішує, чи настав час додати його до маркетплейсу. Для цього він може створити PR із пропозицією перенести скіл до маркетплейсу.
ПОЄДНАННЯ СКІЛІВ
Іноді виникає потреба створювати скіли, які залежать одне від одного. Наприклад, один скіл може завантажувати файл, а інші — створювати CSV-файл і завантажувати його.
Наразі маркетплейси й система скілів не мають вбудованого механізму керування такими залежностями. Проте можна просто посилатися на інші скіли за їхніми назвами, і модель викликатиме їх, якщо вони встановлені.
ОЦІНЮВАННЯ ЕФЕКТИВНОСТІ СКІЛІВ
Щоб зрозуміти, наскільки ефективно працюють скіли, ми використовуємо хук PreToolUse, який дає змогу реєструвати використання скілів всередині компанії. Приклад коду доступний тут.
Завдяки цьому можна виявляти скіли, які мають високий попит, а також ті, що активуються рідше, ніж очікувалося.
З ЧОГО ПОЧАТИ
Найкращі практики створення скілів продовжують розвиватися. Більшість наших найефективніших скілв починалися з кількох рядків інструкцій і одного опису типового підводного каменя. Згодом вони вдосконалювалися, оскільки люди постійно доповнювали їх у відповідь на нові нестандартні ситуації, з якими стикався Claude.
Найкращий спосіб зрозуміти, як працюють скіли, — почати їх створювати, експериментувати та перевіряти, які підходи ефективні саме для вас.